不卷参数卷落地,海马云打通 AI 模型到生产提效的最后一公里
过去三年的大模型竞赛,把行业的注意力几乎全部吸到了参数规模和跑分榜上。实验室和厂商轮流刷新纪录,多模态指标一次次抬高;同一时间段,大量AI应用把模型接进一个对话框,靠提示词完成单次生成,规模越大,亏损越高。模型能力之间的差距正在收窄,仅靠API封装出来的产品,很难形成真正的壁垒。
AI生成内容想真正跑通生产链路,只靠质量好还远远不够。成本得压得住,交付节奏也得跟得上生产步调。几重约束一叠加,单靠一个大模型根本兜不住,海马云创始人兼CEO党劲峰在此基础上给出了更进一步的答案。
消费级AI难赚钱,变现要靠生产力场景
党劲峰认为,消费级AI很难挣到钱,放眼全球能做成的只有极少数巨头,真正能落地变现的只有垂直生产力场景。C端普通用户缺乏持续且强烈的付费动力,这是消费级AI不挣钱的本质原因。在他看来,AI下一程要做的是确定性的系统交付:模型谁都买得到,真正拉开差距的是算力、Harness与数据深度咬合的生产力发动机;没有行业Agent与专家轨迹的AI,终究只是会吐字的玩具。
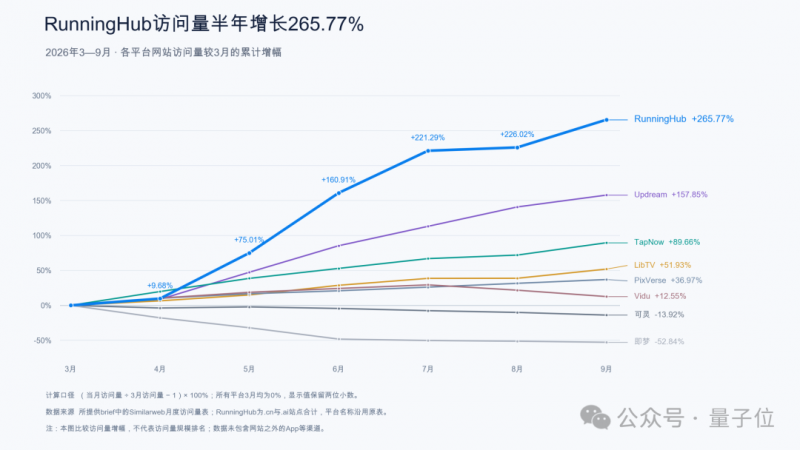
SimilarWeb数据显示,今年3月至9月RunningHub海内外全站访问量增长266%
海马云旗下的RunningHub,正是这套生产力发动机在AIGC领域的落地载体。它提供了一个观察这套系统的窗口:底层GPU支撑推理和渲染,Harness把模型和工具编排成工作流,生产过程中积累的经验再反过来改进模型和Agent。SimilarWeb数据显示,今年3月到9月,RunningHub海内外全站访问量增长了266%,增速在同期主流AI创作平台中位居前列。今年7月,海马云联合创始人兼CTO温健在接受央视《焦点访谈》采访时透露,平台每月的Token消耗量已达9万亿。
算力层:十年云渲染沉淀的底座
同一批GPU在不同时段轮流去跑图像生成、视频生成和专业渲染:统一调度层按任务类型、模型规格和时延要求把算力实时分配出去,推理和渲染放在一张调度表上排班,这种模式叫渲推一体,平台整体算力利用率比行业常见水平高出约70%。
这套调度能力来自海马云十年的云渲染积累,海马云成立于2014年,从实时云渲染起家,《原神》《黑神话:悟空》等游戏的云游戏服务背后都有它的技术支持,如今在全球部署69个计算节点,算力池规模达到6 EFLOPS。
多数纯应用公司没有自研算力底座,全靠租第三方云GPU或转手调用闭源API,毛利率随时受上游价格挤压。海马云和它的客户这边,渲推一体把单位交付成本压下来、交付节奏稳住,综合毛利率保持在较高水平。
模型层:场景化后训练补齐生产短板
模型层上,海马云没跟大厂比拼通用模型参数规模,资源投到了场景化后训练。通用模型图的是广泛适用,影视生产要的是像素级可控,两个目标本来就错位。
真实生产里的麻烦很具体:素材分辨率不够,商业交付过不了关;视频生成慢,创作者等一轮要等六分钟;多镜头叙事里人物对不上,崩坏率高。海马云9月20天内连推三款RH系列模型,正对着这三个问题。素材不够清晰,RH Upscale把低分辨率素材一键超分至4K,皮肤纹理、发丝和织物细节补得回来,主体结构不崩坏,13款主流方案横评综合质量居首。视频生成慢,H3 Lightning把5秒视频的生成时间从6分钟压到28.7秒,提速近12倍,跑在不依赖高端数据中心GPU的RTX 6000D节点上,方法和复现说明都放在了GitHub。多镜头人物对不上,H3 RH Enhanced针对多镜头长叙事做一致性后训练,16个镜头以上的复杂任务里人物崩坏率降低60%以上,最低0.18元/秒。
连MiniMax都开始经由RunningHub反向采购H3 RH Enhanced,给自家客户用。经过场景化后训练的第三方模型,反过来供给大模型厂商,这种事行业里少见,模型调用的决策权正从实验室挪到生产现场。
企业要复用自己的画风,海马云支持创作者和企业用自有作品反复训练,做出专属Checkpoint和风格化LoRA,接进自动化工作流长期调用。头部手游公司干脆把整套游戏视觉体系训练成专属模型矩阵,从原画到场景全部按统一标准输出。
Harness层:把模型接进生产线
Harness层负责组织模型、上下文与工具链,并对最终交付负责。真实生产很少由一次提示词完成,中间要经历任务拆解、多模型协同、工具调用、过程校验和持续迭代。这类系统的价值在垂直行业早有先例:Claude Code底层就是Claude模型,读代码、改文件、跑测试、跟着报错接着修,靠的全是外面那层Harness;做网站生成的Lovable让用户一句描述就得到可上线的站点,今年8月C轮融资4亿美元,估值133亿美元;Figma市值约115.4亿美元,护城河早已移到素材库、版本历史和协作流程上,这些东西沉淀在平台里,搬不走。
在RunningHub上,这套系统拆成三块:Agent管理解意图、拆解任务、调用工具、控制费用、检查结果;工具链里有画布、ComfyUI工作流、LoRA训练、云电脑,还有Blender、Unreal这些专业软件;上下文里装着影视、电商、短剧、游戏、建筑各行业的专家知识和know-how。据海马云介绍,RunningHub已有约60%的模型调用由智能动态路由完成:Agent先识别用户的意图,再结合行业上下文拆解任务,简单任务交给小模型处理,复杂任务交给大模型完成,电商图、电影感画面、短漫剧各有对应的模型承接。
数据层:专家轨迹与行业know-how
数据层沉淀的是合规获取的生产现场数据与专家决策轨迹;工具和流程都能被别人复刻,这一层搬不走。资深创作者完成任务时选了哪个模型、调了哪些节点、一条视频改了几轮、每轮调的是光影还是表情,脱敏后的完整操作序列会被记录下来,在垂直后训练中转化为强化学习的奖励信号,模型原本要反复试错十步的活儿,后来一次推断就能完成。这类专家交互数据在通用大模型的训练语料里几乎不会出现,却是垂直后训练最缺的养料。
行业know-how则被结构化为可复用的Skill与知识库:游戏美术的画风控制、电商操盘手的爆款转化配方、影视导演的镜头语言,这些由创作者授权贡献的资产正在被结构化提炼。RunningHub作为国内较早的AIGC开源社区之一,已积累百万级开源工作流,每天仍以千条左右的速度增长。知识库目前分为产品知识与创作知识两部分,下一步海马云还将按行业建库,率先覆盖电商、影视短剧和广告。
企业在平台上长期积累的ComfyUI工作流、训练好的LoRA以及VI规范,构成了极高的迁移成本。品牌设计师把VI规范交给Agent之后,后续生成的每一张图都会自动遵守品牌规范。平台能否把这些资产管理好、复用好,将直接决定客户会不会留下来。据海马云介绍,自建工作流沉淀较多的用户,留存率接近100%。某建筑设计公司接入RunningHub后,针对建筑效果图痛点自建了结构修复等7个应用与14个工作流,月投入增长超10倍;某手游研发公司训练80余个专属LoRA、搭建超160个自建工作流,三个月内用量增长近70倍。
应用层:从垂直场景到商业交付
最上面的应用层承载RunningHub、rhTV、RHSTORY等多样化产品生态,完成从垂直场景到商业交付的最后一跳。某电商AI服务商去年年底接入RunningHub后,一个月内就搭建了47个自建应用,覆盖商品图到短视频的完整制作流程,并提供给旗下100多个商家账号使用,最近两个月连续56天每天调用,累计调用超过12万次,月投入增长700%。海马云还在向更多垂直场景延伸,接下来将推出面向其他行业的应用产品,把这台生产力发动机复制到更多行业。
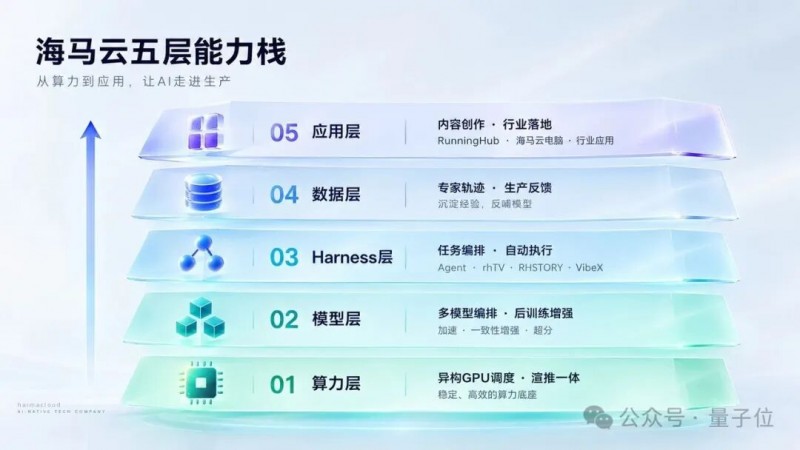
海马云五层能力栈:算力层、模型层、Harness层、数据层、应用层
党劲峰坦言,AI产业不需要所有公司都去造大模型,但需要有人让大模型真正干好活。海马云关注的不是模型有多大,而是模型距离真实生产还有多远。当模型能力差距日趋收窄,拉开差距的正是这套层层联动、自循环的五层能力栈。