

骁龙 8 Elite Extreme Gen 6,非官方简称为骁龙 8EE6,发布以来就成为新一代旗舰手机性能与AI能力的支撑。对这颗芯片的讨论,多数聚焦在峰值性能与智能体AI的支持程度上,能效作为一个整体议题,往往被简化为单一跑分数字。
而智能体AI带来的实际问题是:芯片需要在后台持续感知、记忆、准备执行,功耗不再是 “某一瞬间”的问题,而是“每一毫瓦如何分配”的问题。这直接关系到能效评价的维度:峰值能效与持续能效。这往往不是同一个答案,单核能效与整机能效,也未必指向同一结论。
面对这种负载模式的变化,骁龙8EE6在感知、调度、推理、渲染等环节的能效设计分别做了什么取舍?官方公布的能效数据,如何对应到智能体工作流的不同阶段?每一层的能效优化,在真实使用中又会带来哪些可感知的差异?能效对端侧智能体AI而言,究竟是锦上添花,还是落地的前提?下面我们结合技术细节详细解读。
首先需要明确的是,在智能体时代,AI对能效的要求,和过去的移动AI完全不同。过去芯片的AI能力是“事件驱动”的——用户触发一次,芯片响应一次,功耗集中在那个瞬间。而智能体AI要求芯片在后台持续感知、持续记忆、持续准备执行任务。这意味着能效不再是“峰值时省一点电”的问题,而是“在长时间低活跃度运行中,每一毫瓦花在哪里”的问题。骁龙8EE6的能效设计,正是沿着这条“持续性”的线索展开的。官方数据显示,骁龙8EE6的CPU能效相比上一代提升37%,GPU能效提升40%,NPU每瓦性能提升33%,Sensing Hub能效提升约20%,这对应的是智能体工作流上不同的环节,而非某一个孤立的省电模式。
感知层:Sensing Hub如何把“持续在线”的功耗压下来
智能体AI与普通语音助手的区别之一,是它需要在用户没有主动唤醒时,也能持续感知情境。位置变了、活动状态变了、周围环境变了,这些信息是智能体做出判断的基础。
骁龙8EE6的Qualcomm Sensing Hub承担的就是这部分工作。它采用双Micro NPU设计,性能较上代提升约85%,能效提升约20%,可以运行最高约2亿参数的小模型。它的核心价值不在于算力有多强,而在于让系统在不唤醒主应用处理器的情况下保持持续警觉。主CPU和主NPU不需要为了感知而一直待命,智能体“醒着”的那部分工作,被交给了一个专门为低功耗常驻运行而设计的子系统。这是能效分层的第一道闸门:感知的归感知,计算的归计算,两者不在同一个功耗预算里竞争。
调度层:FlexCache让任务切换不反复“搬家”
当Sensing Hub判断需要执行任务时,工作交给CPU。智能体的任务流不是一条直线:规划、调用工具、等待结果、切换线程、再继续推理。线程会在超级内核和性能内核之间来回迁移,如果每次迁移都伴随数据回写系统内存再重新加载,延迟和功耗会同时累积。
骁龙8EE6的Oryon FlexCache针对的正是这个环节。它把L2缓存统一成一个由异构核心动态共享的缓存池,超级内核在高负载时可以调用几乎整个缓存池,让更大的工作集留在缓存中而无需频繁回写至系统内存。高通对此的定位很明确:FlexCache要缓解的正是智能体场景下“跨核切换卡顿”和“响应延迟”的问题。CPU能效提升37%,除了2nm工艺的物理红利,FlexCache减少数据搬运的作用同样关键——对于智能体这种“多步、频繁切换”的负载,能效的改善不在于让某一刻跑得更快,而在于让每一次切换的固定开销降下来。
推理层:NPU的能效优化为什么落在“内存”上
智能体AI最核心的计算负载落在NPU上。端侧大模型推理有一个工程现实:解码阶段的主要成本往往不是矩阵运算本身,而是KV缓存的读写。模型每生成一个词元,都需要访问保存对话上下文的缓存。如果NPU的片上空间不足,这些数据就要在主内存和NPU之间反复搬运,时延和功耗同时上升。
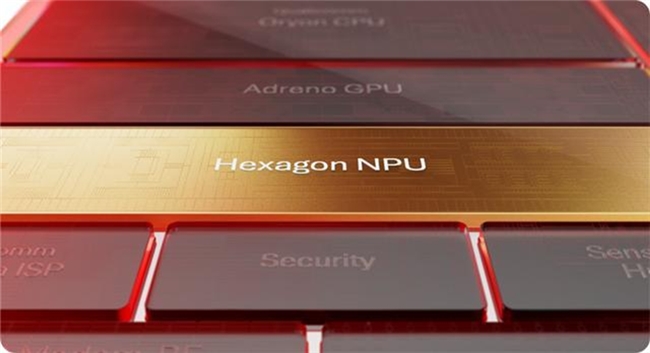
骁龙8EE6的Hexagon NPU把大容量共享内存扩容了50%,NPU性能提升35%,每瓦性能提升33%。扩容之后,上下文和KV缓存可以保留在NPU内部,减少与外部DDR之间的数据往返。Element Accelerator则专门为Transformer工作负载加速预填充阶段,针对部分模型,预填充性能最高可提升80%。这套组合的核心逻辑始终一致:让数据靠近计算单元,把能效优化的重心放在减少数据搬运上,而不是单纯压缩算力。
这也解释了300亿参数MoE模型为什么能在端侧成立。MoE每次推理只激活约30亿个被路由选中的参数,计算量本身就低于同规模稠密模型;加上NPU共享内存扩容减少了KV缓存的搬运开销,能效账才算得过来。高通与阶跃、无量火、江波龙的四方合作进一步验证了这一点:在不损失精度的前提下,30B-MoE模型的运行内存需求较行业常规方案降低超50%,能效是端侧大模型可持续运行的前提。
GPU的能效逻辑:把省下来的功耗留给持续输出
图形侧的能效设计遵循同样的原则。Adreno GPU的18MB HPM独立高速显存让渲染中间数据留在GPU片上,减少对系统内存的往返访问,官方数据是带来约12%的功耗改善。Adreno Neural Fusion则让AI超分和帧生成在图形管线内部完成,在支持的场景中最高可节省40%功耗。这两项设计合在一起,让GPU在图形输出上的单位功耗下降。
能效分层背后的判断:智能体AI需要的是“会分配电”的芯片
把四个环节放在一起看,骁龙8EE6的能效设计呈现出一条清晰的对应关系:Sensing Hub以低功耗承担持续感知,FlexCache降低CPU任务切换的数据搬运成本,NPU共享内存扩容压缩大模型推理的KV缓存往返,GPU片上显存为图形输出留住持续性能。没有哪一个模块是在孤立地“省电”,每一层的优化都对应着智能体工作流上的一类具体动作。
智能体AI的能效评价标准,正在从“峰值时每瓦能跑多少分”转向“持续运行时每一毫瓦是否花在了该花的地方”。骁龙8EE6的能效体验覆盖了感知、调度、推理、渲染四层,恰恰是在回应这个转变。当AI变成“常驻后台”,芯片持续的能效表现,或许比单一跑分更有说服力。
