UIUC等提出A2D框架 让模型主动生成高价值蒸馏问题
在线策略蒸馏研究中出现一个值得留意的现象:即便训练问题数量很少,学生模型也可能从教师模型处获得明显提升。由此产生的新问题是,能否让模型主动生成最有利于自身学习的问题;如果这些问题没有标准答案,也没有外部验证器,又该如何判断哪些问题真正值得用于训练。
来自伊利诺伊大学厄巴纳-香槟分校、香港科技大学和德克萨斯农工大学等机构的研究者提出Ask-to-Distill框架,简称A2D。该框架把训练问题视为触发教师监督信号的分布诱导器,直接根据教师和学生的预测分布衡量一道问题能带来多少可利用的监督,再用强化学习优化问题生成器。
A2D先复制初始学生模型的参数,用它初始化问题生成器。生成问题后,冻结的学生模型负责作答,冻结的教师模型沿着学生生成的同一轨迹进行预测,系统由此获得每个token位置上教师与学生的概率分布。整个强化学习过程中,教师和评分学生保持冻结,只有问题生成器被更新,因此被优化的是学生接下来会遇到什么问题,而不是学生本身的解题参数。
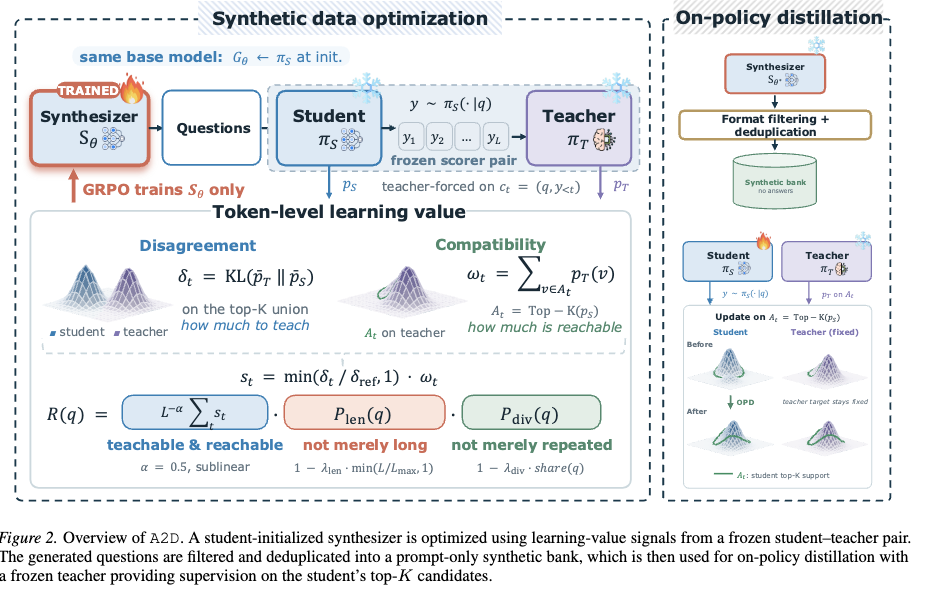
仅看教师与学生的KL分歧并不够。若教师的主要概率集中在学生Top-K候选之外,即使分歧很大,也未必能转化为有效监督。A2D因此引入两个互补指标:Disagreement衡量师生预测分布的差异,Compatibility衡量教师有多少概率质量落在学生的Top-K候选token上。两者结合成support-aware学习价值信号,使奖励更偏向学生尚未掌握、但教师能提供纠正方向的位置。
系统把token级信号聚合为问题级奖励,并使用GRPO训练问题生成器。为了避免生成器靠超长回答或重复问题刷分,奖励中加入次线性长度归一化、过长回答惩罚和多样性约束。训练完成后,A2D批量合成问题,再经过格式过滤、词汇去重和语义去重,构建最终问题库;这个库只保存问题,不保存标准答案。
后续蒸馏阶段从原始学生模型重新开始。学生自主生成回答,冻结教师提供token级监督,完成标准OPD训练。整个过程不需要外部训练问题、人工标注答案或额外奖励模型;独立Embedding模型只用于问题生成后的语义去重,不参与强化学习奖励计算。
在数学推理任务中,Qwen3-1.7B原始学生平均得分为25.7,使用真实数据做OPD后升至43.0,A2D进一步达到46.2,恢复约90.2%的师生性能差距。DeepSeek-R1-Distill-Qwen-1.5B上,A2D平均得分51.6,接近教师的51.7;DeepSeek-R1-Distill-Qwen-7B则从58.1提升到64.5。多组学生教师组合中,A2D在六个基准上的平均成绩均为最高。
代码生成实验中,Qwen3-4B-Instruct-2507作为教师、Qwen3-4B作为学生时,原始学生六项平均成绩为28.7,真实数据OPD达到34.5,A2D升至39.6。LiveCodeBench上,学生成绩从21.6提升到35.9,超过教师参考成绩33.7,但其他代码基准上仍存在差距。智能体任务中,A2D在Airline、Retail和Telecom三个领域分别取得46.3、49.4和30.0,平均41.9;相比学生生成问题的OPD平均37.3有所提升,师生差距恢复率从79.2%升至95.2%。
案例分析显示,一道真实数学题诱导的学生回答长度为2002个token,平均token学习信号约0.117;一道A2D合成问题只产生1241个token,平均信号约0.172,约为前者的1.5倍。对1000道真实数学问题和1000道A2D合成问题进行比较后,学生回答平均长度从约1280个token降至1021个token,减少约20%;累计support-aware学习信号从141.7提高到181.7,增加约28%,并且整个回答过程中都维持较高信号水平。
研究团队还在1500道真实数学问题上考察分布信号与学习收益的关系。平均分歧与单步学习收益的Spearman相关系数为0.727,控制回答长度、通过率和熵后偏相关系数为0.386;support-aware信号的原始相关系数为0.750,偏相关系数为0.399。按信号大小分成五组后,最高信号组带来的探针KL下降幅度约为最低组的2.15倍。消融实验中,移除兼容性、多样性约束或长度惩罚都会造成性能下降;完整奖励函数在AIME24、AIME25和AIME26上的成绩分别为45.0%、35.8%和29.2%。